原文标题:How I'd Become a Quant If I Had to Start Over Tomorrow
原文作者:gemchanger,coldvision 创始人
翻译、注释:MrRyanChi,insiders.bot
在 2026 年,量化交易是每个交易员的基础素养
上个礼拜,我受到香港大学人工智能与管理协会(@camo_hku)的邀请,交流分享了 Agent 时代的那些搞钱方法。整个活动下来,我最大的收获就是一件事,那就是:
AI 时代 = 技术平权的时代
过去,量化是小部分机构的专属。现在,无数工作室甚至个人参与到了创造量化策略,并且获得持续收益的过程当中。换言之,如果你还不理解量化的本质,那么你将会在市场上面临很大的劣势。
在 OpenClaw 盛行的今日,任何人都可以靠量化赚钱。但这需要两个前提。
第一,是基础设施,这正是我们在 @insidersdotbot,通过制作 Agent 和算法原生的交易平台,数据库与 Skills 正在试图实现的。正式版基于 Agent 的回测功能,也会是这个生态的一部分。
第二,也是作为个体最重要的,就是架构能力和策略的设计能力。策略并不需要 100% 精确,但一定要独特,精巧,可以抓到别人意识不到的大机会。
只要你有专属于你的策略 牛逼的底层设施,那么,佐以 Vibe Coding 的赋能,你就离财富自由不远了。
而在学习策略与架构这件事情上,@gemchange_ltd 这篇原文,是我目前看到的、最完整的一份「量化交易知识地图」。它以预测市场为印子,把成为一名顶尖宽客(量化交易员/Quant)所需要的每一块拼图,按照正确的学习顺序,一次性讲清楚了。
相信看完它,就算是小白,你也能了解如何开始量化交易,以及如何设计属于你的策略。
如果你是预测市场交易员,那这就是你必读的文章。
如果你是其他资产的交易者,这篇文章的很多思路都是通用的,相信你也能受用无穷。
原文非常硬核且学术。为了让任何刚接触 Polymarket、甚至没有任何数学背景的用户也能看懂,我进行了大量的改写和补充。我假设你对复杂的数学一无所知,为你增加了 20 张全中文的图解,并用最接地气的大白话、通俗的类比和实际的例子,帮你拆解每一个概念。
如果你想在预测市场里长期赚钱,而不是当一个赌徒,这篇文章就是你的起点。
对了,这篇文章在结构上针对 Agent 进行了优化。就好像 insiders.bot 平台对真人和 AI 交易员都进行了优化一样。所以,欢迎大家把这篇文章喂给你的 OpenClaw,Manus,Claude,或者任何一个 AI,然后立刻开始建立你的量化模型。
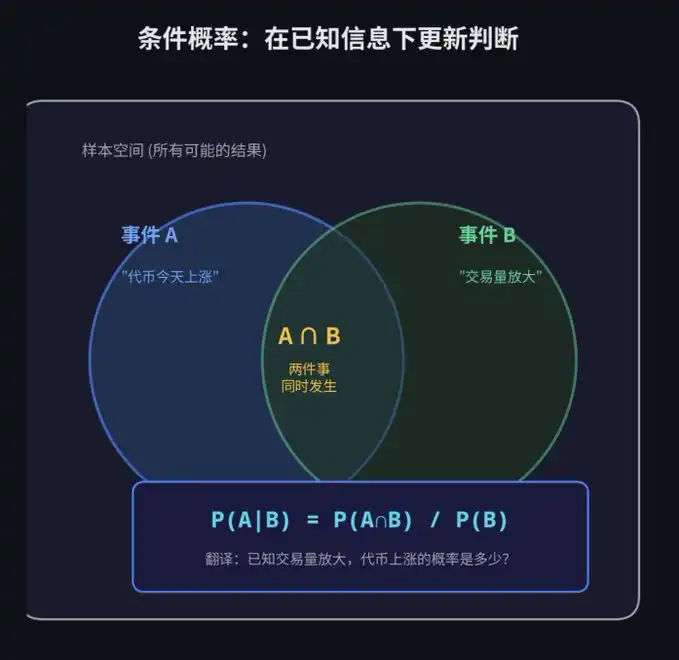
贝叶斯定理:如何实时更新你的信念
贝叶斯定理是量化交易的灵魂。它回答的问题是:当你获得了新的数据,你应该如何更新你原有的信念?
它的公式是这样的:
P(A|B) = P(A∩B) / P(B)
* P(A|B) :已知 B 发生了,A 发生的概率
* P(A∩B):A 和 B 同时发生的概率
* P(B):B 发生的概率
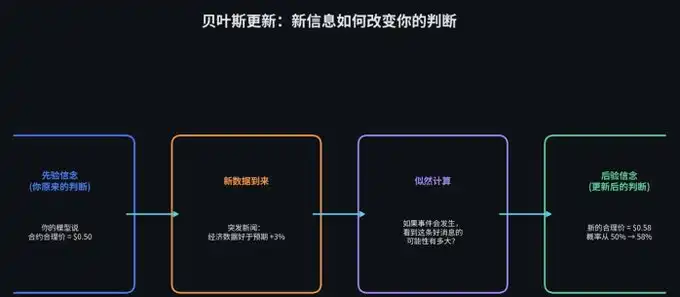
贝叶斯定理的逻辑本质上是这样的:
* 你心里先有一个预估(比如:我觉得这件事有 50% 的概率发生)。
* 突然,你看到了一个新证据(比如:出了一条利好新闻)。
* 你问自己两个问题:如果这件事真的会发生,出这条新闻的可能性有多大?如果这件事根本不会发生,出这条新闻的可能性又有多大?
* 根据这两个问题的答案,你调整你心里的预估(比如:从 50% 调高到 58%)。
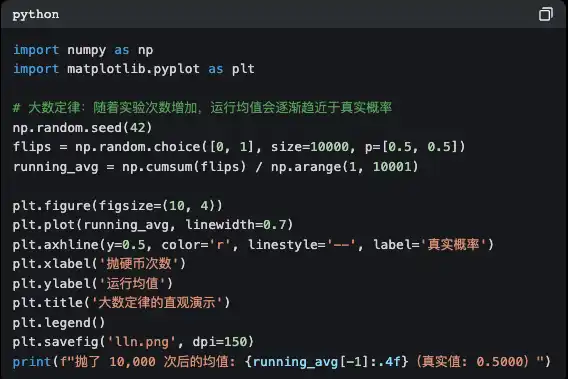
如果你想打好基础,去读一读哈佛大学免费的《Introduction to Probability》(概率论导论),前 6 章就够了。然后试着用 Python 写个代码,模拟抛 10,000 次硬币,亲眼看看大数定律是怎么运作的。
期望值与方差:你最好的两个朋友
在交易中,有两个数字比什么都重要。
期望值(Expected Value, EV),你的确信度。
如果一笔交易的期望值是正的,意味着只要你重复做足够多次,长期来看你一定会赚钱。
方差(Variance),你的风险。
它告诉你,在到达那个赚钱的「长期」之前,你会经历多大的上下颠簸。
举个例子。假设你有一个策略,每笔交易的期望收益是 $2,但标准差是 $50。这意味着虽然你「平均」每笔赚 $2,但单笔交易的结果可能在亏 $100 到赚 $100 之间剧烈波动。如果你的本金只有 $200,你可能在「长期」到来之前,就已经连亏三把爆仓出局了。
第二章:统计学 = 你的噪音探测器
当你学会了概率的语言,下一步就是学会「倾听数据」。
这就是统计学。
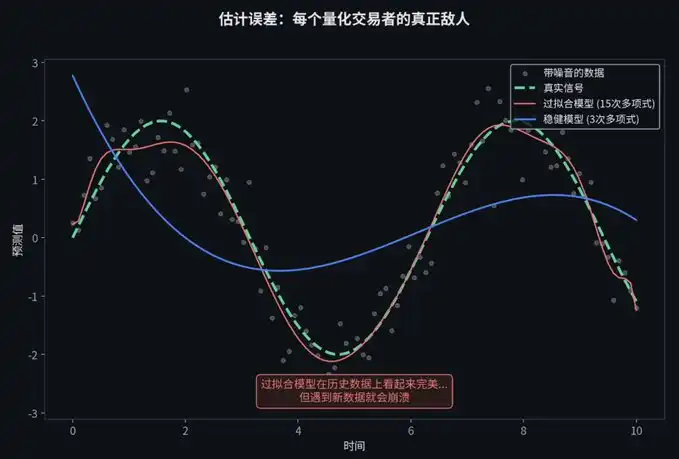
统计学教给我们的第一课就是:绝大多数看起来像「信号」的东西,其实都是噪音。
假设检验与多重比较陷阱
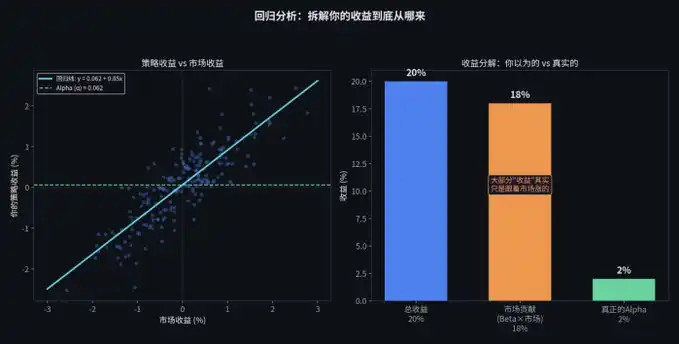
假设你写了一个交易机器人,回测数据显示它每年能赚 15%。这是真的吗,还是只是运气好?
这时候你需要算一个 p 值(p-value):如果这个策略其实是个垃圾(纯靠蒙),它能碰巧跑出 15% 收益的概率有多大?统计学就能告诉你,这个概率有多小(比如小于 5%)。
但是,这里有一个巨大的陷阱,叫做多重比较问题(Multiple Comparisons Problem)。
想象一下,你让 1,000 只猴子各扔 100 次飞镖。纯粹靠运气,总有几只猴子能连续命中红心,看起来简直就是「飞镖大师」。但你不会因此就雇它们当投资经理,对吧?
写交易策略也是一样。如果你用电脑自动生成了 1,000 个瞎蒙的策略去跑历史数据,纯靠运气,也会有大约 50 个策略看起来能赚大钱。
每一个刚刚入行的新手,都会严重高估自己发现的「有效策略」。我可以负责任地告诉你,你写出的前 10 个策略,绝对都是那几只运气好的猴子。
最大似然估计(MLE):反向推理的艺术
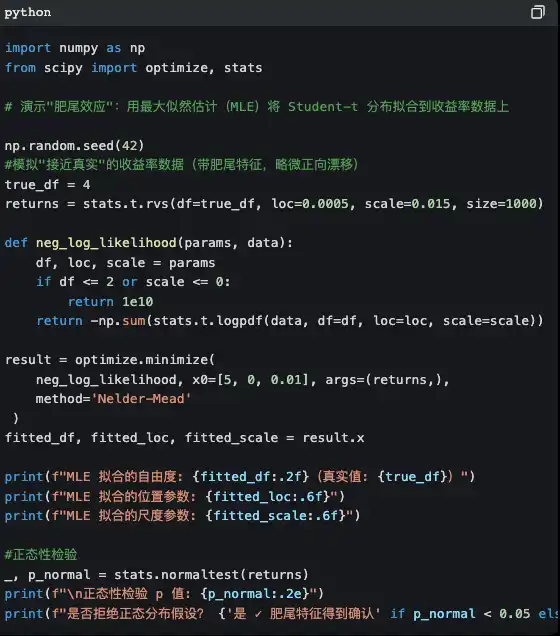
当你听到一家顶级机构的宽客说他们在「校准」一个模型时,他们几乎永远是在说一件事:最大似然估计(MLE)。
MLE 的原理其实很好懂,它就是一种「反向推理」。
打个比方。你在路边看到一个直径 2 米的水坑。你想知道昨晚下了多大的雨。你有一个「降雨模型」,告诉你不同降雨量会产生多大的水坑。
MLE 做的事情就是反过来推:既然我已经看到了一个 2 米的水坑,那么在所有可能的降雨量中,哪一个降雨量最有可能造出这么大的水坑?
无论是给波动率拟合一个 GARCH 模型,还是根据市场报价校准期权定价,MLE 都是核心工具。
在交易中也是一样。你看到了市场上期权的价格(水坑),你想反推市场对未来波动的预期(降雨量)。MLE 就是帮你找到那个「最能解释当前价格」的隐藏参数。
如果你不能流利地使用矩阵来思考,你就不可能成为一名宽客。
协方差矩阵:理解资产的联动
一个协方差矩阵 Σ(Sigma)捕捉了每一个资产相对于其他所有资产是如何移动的。
如果你在看 500 个市场,这个矩阵就是 500×500 的大小,包含 125,250 个独特的条目。每一个条目都在告诉你:「当资产 A 涨的时候,资产 B 倾向于涨还是跌,涨跌的幅度有多大。」
而整个投资组合的方差,可以坍缩成一个极其优雅的数学表达式:
σ²_p = w^T Σ w
* w 是你的持仓权重向量
* Σ 是协方差矩阵
这个二次型公式,是马科维茨(Markowitz)投资组合理论的核心,是风险管理的核心,是一切的核心。
换言之,如果你同时在多个相关的盘口交易(比如「特朗普赢得大选」和「共和党赢得参议院」),你的总风险不是简单地把每个市场的风险加起来。你需要考虑它们之间的相关性。而协方差矩阵,就是帮你做这件事的工具。
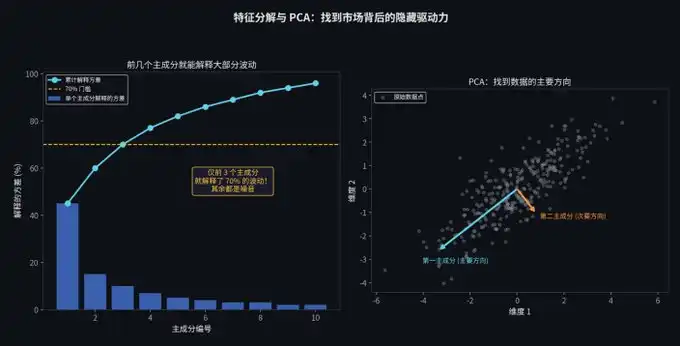
如果有足够的时间,建议去看看 MIT 的 Gilbert Strang 教授的线性代数公开课。然后用 Python 对标普 500 的收益率做一次 PCA 分解,亲眼看看前几个主成分是什么。
你会发现,第一个主成分几乎等于「整个市场的涨跌」。
第三章课后作业(约 4-6 周完成):
1. 观看视频: 看完 Gilbert Strang 的 MIT 18.06 线性代数全部课程视频,一节都不能跳。(MIT OpenCourseWare 免费观看:https://ocw.mit.edu/courses/18-06-linear-algebra-spring-2010/video_galleries/video-lectures/)
2. 阅读:阅读 Strang 的《Introduction to Linear Algebra(线性代数导论)》,做书中的习题。(教材官网:https://math.mit.edu/~gs/linearalgebra/)
3. 编程练习 1:对标普 500 的收益率数据做 PCA(主成分分析)分解,画出特征值谱(即每个主成分解释了多少方差),找出前 3 个最重要的主成分。
4. 编程练习 2:从零开始实现 Markowitz 均值-方差优化。
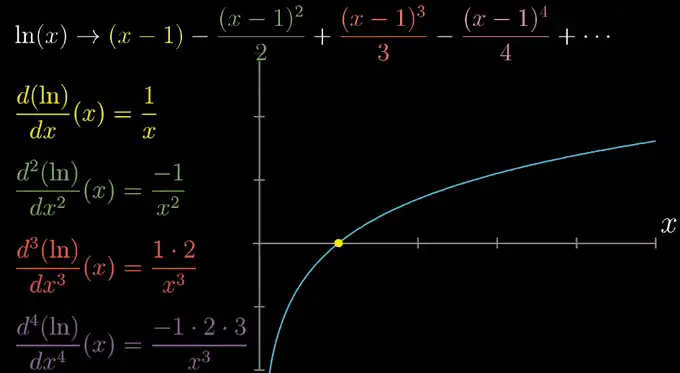
假设你要画一条非常复杂的弯曲曲线,但你手里只有直尺。怎么办?
第一步,你用一根直线去贴合曲线的某一点(这叫一阶近似,在期权里叫 Delta)。在这一点附近,直线和曲线差不多。
第二步,如果你想贴合得更好,你可以把直线稍微掰弯一点,变成一个抛物线(这叫二阶近似,在期权里叫 Gamma)。
你掰弯的次数越多,你画出的线就越贴近那条复杂的曲线。
在交易中,期权的价格变化是一个极其复杂的公式。我们算不过来,所以就用泰勒展开,把它拆解成几个简单的部分:
价格方向的影响(Delta) 价格弯曲程度的影响(Gamma) 时间流逝的影响(Theta) 波动率变化的影响(Vega)。
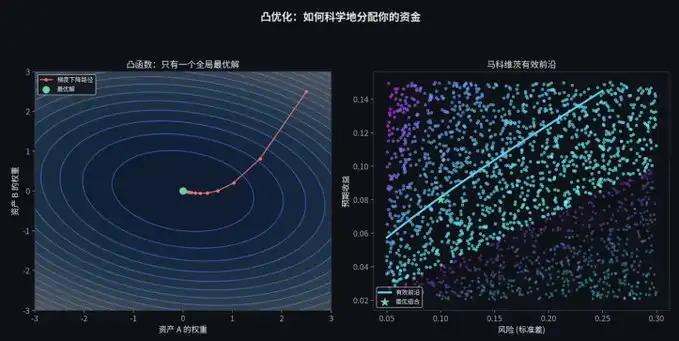
只要你能把金融问题写成一个「碗」状的数学公式,电脑就能瞬间帮你找到最完美的答案。这就是凸优化为你做的事情。原文作者提到,斯坦福大学的 Boyd 和 Vandenberghe 写了一本免费的教材《Convex Optimization》,是这个领域的圣经。Python 的 cvxpy 库可以让你用几行代码就解决复杂的优化问题。
这里也顺手推荐一波 Andrew Ng 的 AI 课程,前几期就会提到梯度下降和局部最优/全剧最优。方便大家更好理解凸优化的必要性。链接:https://www.youtube.com/watch?v=JPcx9qHzzgk
第四章课后作业(约 4-5 周完成):
1. 阅读:阅读 Boyd & Vandenberghe 的《Convex Optimization(凸优化)》第 1 至第 5 章。(斯坦福提供免费 PDF 版本:https://web.stanford.edu/~boyd/cvxbook/bv_cvxbook.pdf,书籍主页:https://stanford.edu/~boyd/cvxbook/)
2. 编程练习 1:从零开始实现梯度下降算法,用它来求 Rosenbrock 函数的最小值。(Rosenbrock 函数是优化领域最经典的测试函数之一,看起来简单但实际上很难优化,非常考验算法性能。)
3. 编程练习 2:用 cvxpy 求解一个投资组合优化问题,并加入交易成本约束。
第五章:随机微积分,从数据科学家到真正宽客的蜕变
在学会随机微积分之前,你只是一个「喜欢金融的数据科学家」。学会了它之后,你才是一个真正的宽客。
这是你学习如何在连续时间中对随机性进行建模的地方。在这里,你将从第一性原理推导出著名的 Black-Scholes 方程,并真正理解为什么价值万亿美元的衍生品市场会以现在的这种方式运转。
*注 5.1:想要更好地了解 Black-Scholes 方程以及其含义,可以参考上一篇「Polymarket 做市圣经」。链接:https://x.com/MrRyanChi/status/2033466480067747844
*注 5.2:为什么随机微积分(Itô calculus)和普通的微积分不一样?正是因为在随机过程中,二阶泰勒项不会消失。在普通微积分里,当时间间隔趋近于零时,二阶项可以忽略不计。但在随机过程中,由于布朗运动的特殊性质,(dW)² = dt,二阶项变成了一阶的量级,不能忽略。详情见下文。
布朗运动:纯粹随机性的数学表达
布朗运动(也叫维纳过程,W_t)是一个连续时间的随机游走。
想象一个醉汉在广场上走路。他每走一步,方向都是完全随机的。他走出的那条歪歪扭扭、毫无规律的轨迹,就是布朗运动。股票价格的跳动,在数学上就被看作是这种醉汉的步伐。
布朗运动的例子还有很多,比如科学上,空气粒子的运动也是随机的布朗运动。
这里有一个决定一切的洞察:在布朗运动中,时间的流逝和距离的平方是等价的(即 (dW)² = dt)。正是因为这个性质,随机微积分才跟普通微积分不一样。
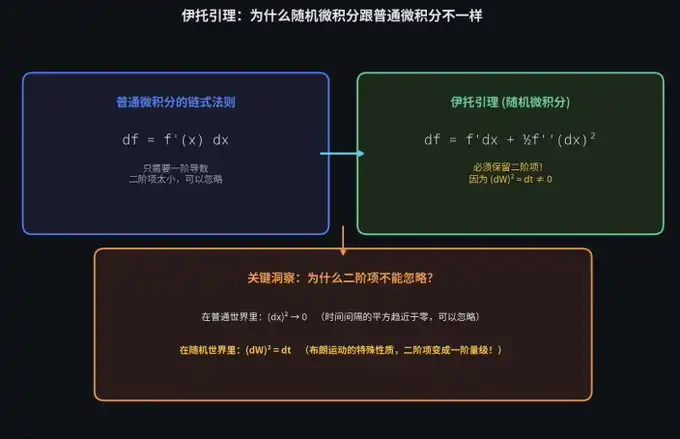
这意味着什么?这意味着期权的价格,根本不依赖于你对这只股票未来是涨是跌的预期。
也就是说,假设你在买一个看涨期权。你以为期权越贵,是因为大家越看涨。错!在完美的数学模型下,期权的价格只跟一个东西有关:这只股票未来的波动有多剧烈。至于它是剧烈地上涨还是剧烈地下跌,根本不重要。
当你第一次真正理解这个概念时,那种感觉是极其震撼的。它解释了为什么一个极度看涨的交易员和一个极度看跌的交易员,可以在同一个期权价格上愉快地达成交易。因为他们交易的根本不是方向,而是波动率。
希腊字母(The Greeks):拆解风险的维度
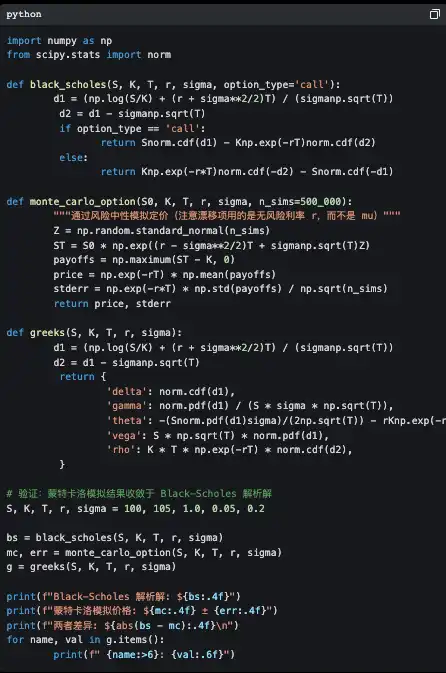
有了 Black-Scholes 定价模型,风险就可以被精确拆解成几个独立的维度。这些维度用希腊字母命名,所以叫做 Greeks:
* Delta (Δ) - 价格敏感度:标的资产变动 $1,期权价格变动多少。它直接告诉你需要买多少现货来对冲风险。
* Gamma (Γ) - 弯曲程度:Delta 的变化速度。它告诉你需要多频繁地调整你的对冲仓位。在事件概率接近 50% 时,Gamma 最大,风险也最高。
* Theta (Θ) - 时间衰减:每过一天,期权损失多少价值。你可以把它理解为持有期权每天需要交的「租金」。
* Vega (V) - 波动率敏感度:波动率变化 1%,期权价格变多少。这是大多数华尔街衍生品交易台真正赚钱(或亏钱)的地方。
* Rho (ρ) - 利率敏感度:利率变化对价格的影响。通常影响较小,可以忽略。
第六章:Polymarket 与 LMSR,预测市场的数学引擎
现在,让我们把所有的数学武器,带回到当今世界上最有趣的交易市场:Polymarket。
Polymarket 背后的数学,完美地连接了这篇文章里提到的所有东西:概率论、信息论、凸优化和整数规划。
LMSR = 神经网络的 Softmax
在早期的预测市场中,自动做市商(AMM)通常使用一种叫做 LMSR(Logarithmic Market Scoring Rule)的机制。这是由经济学家 Robin Hanson 发明的。
它的成本函数是:C(q) = b · ln(Σ e^(q_i/b))其中:
* q_i 是某个结果的未平仓份额
* b 是流动性参数(b 越大,市场越「厚」,价格越难被大单推动)。
根据这个成本函数,我们可以算出任何一个结果 i 对应的盘口价格:
p_i = e^(q_i/b) / Σ_j e^(q_j/b)
如果你懂一点机器学习,看到 LMSR 的价格计算公式,你会立刻惊呼:这不就是 Softmax 函数吗!
什么是 Softmax?假设你有三个苹果,分别重 100 克、50 克、20 克。你想把它们的重量转换成「百分比概率」。Softmax 就是一个「概率转换器」。它不仅能把这些数字变成加起来等于 100% 的概率,而且它会放大差异。稍微重一点的苹果,会分到大得多的概率份额。
2. 工具已经民主化了,但「确信度」没有
今天,任何人都可以免费下载 PyTorch。任何人都可以接入 Polymarket 的 API。技术是必要条件,但不再是充分条件。
真正的交易优势(Edge),存在于独特的数据、独特的模型,或者独特的执行能力中。不是比别人多装了几个 Python 库。
这也是为什么我们把 @insidersdotbot 的更新推迟了整整一个月,来优先完善我们的聪明钱库,以及更好的 PNL 计算算法(比如比官方更准确的 Split 收益计算模式)。因为独特的数据和模型,真的能够帮你赚更多的钱,或者转亏为盈。
在 Polymarket 上,这意味着什么?
意味着你需要找到别人没有的信息来源(比如某个小众领域的专家网络),或者构建别人没有的模型(比如一个能实时处理多市场相关性的定价引擎),或者拥有别人没有的执行能力(比如一个能在 10 毫秒内完成跨市场对冲的交易系统)。
3. 数学才是真正的护城河
AI 可以帮你写代码,甚至可以建议交易策略。但是,能够推导出为什么伊托引理多了一项,能够证明在风险中性测度下折现价格是鞛(Martingale),能够判断在一个组合市场中凸松弛(Convex relaxation)何时是紧的。
这种深厚的数学直觉,才是区分「创造优势的宽客」和「借用优势的宽客」的根本分水岭。而借来的优势,迟早是会过期的。
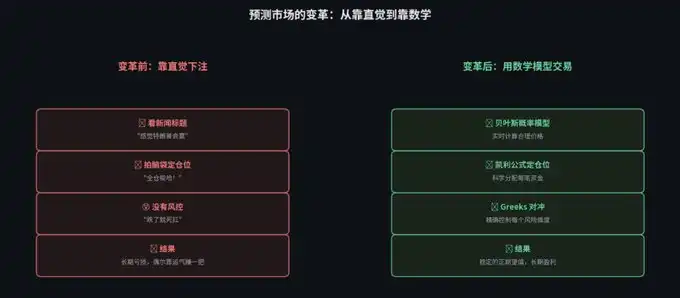
预测市场正在经历传统期权市场在 1973 年经历过的变革。那些能够率先把严谨的数学模型、波动率定价和复杂的套利算法引入这个市场的人,将会拿走最大的红利。
停止靠直觉下注吧。去学概率,去写代码,去构建你的数学护城河。
完整工具箱
Python 技术栈
数据处理:pandas、polars(Polars 在处理大数据集时比 pandas 快 10 到 50 倍)
数值计算:numpy、scipy
机器学习(表格数据方向):xgboost、lightgbm、catboost
机器学习(深度学习方向):pytorch
优化求解:cvxpy
衍生品定价:QuantLib(工业级别的库,底层是 C 写的,性能很强)
统计分析:statsmodels
回测框架:NautilusTrader
回测框架(更简单易上手的选择):backtrader、vectorbt(适合入门)
量化研究平台:Microsoft Qlib(GitHub 上超过 17000 颗星,偏 AI 方向)
强化学习交易:FinRL(GitHub 上超过 10000 颗星)
C 和 Rust
C 常用库:QuantLib、Eigen、Boost
Rust 方面:RustQuant 可以用来做期权定价,NautilusTrader 采用的是 Rust Python 混合架构(底层核心用 Rust 保证速度,上层用 Python API 方便做研究)。
数据源
免费的:yfinance、Finnhub(每分钟 60 次请求限制)、Alpha Vantage
中等价位的:Polygon.io(每月 199 美元,延迟低于 20 毫秒)、Tiingo
企业级的:Bloomberg Terminal(彭博终端,大约每年 32000 美元)、Refinitiv、FactSet
区块链数据:Alchemy(有免费套餐,支持历史存档数据访问)
除此之外,@insidersdotbot 即将开源 API。将会包含现成的聪明钱数据库与交易功能。欢迎点击小铃铛 Stay Tuned。
求解器
Gurobi:速度最快的商用混合整数规划求解器,学生和学术用户可以申请免费许可证。做组合套利类问题离不开它。
Google OR-Tools:免费求解器里面最强的。
PuLP / Pyomo:Python 建模接口,用来方便地定义和调用各种求解器。
参考资料
[1] gemchanger. (2025). How I'd Become a Quant If I Had to Start Over Tomorrow. X.
https://x.com/gemchange_ltd/status/2028904166895112617
[2] Blitzstein, J. K., & Hwang, J. (2014). Introduction to Probability. CRC Press.
https://projects.iq.harvard.edu/stat110
[3] Markowitz, H. (1952). Portfolio Selection. The Journal of Finance.
[4] Strang, G. MIT 18.06 Linear Algebra. MIT OpenCourseWare.
https://ocw.mit.edu/courses/18-06-linear-algebra-spring-2010/
[5] Boyd, S. & Vandenberghe, L. (2004). Convex Optimization. Cambridge University Press.
https://web.stanford.edu/~boyd/cvxbook/
[6] Hanson, R. (2003). Logarithmic Market Scoring Rules for Modular Combinatorial Information Aggregation.
[7] Polymarket Documentation. CLOB Overview & API.
https://docs.polymarket.com/trading/overview
[8] Black, F., & Scholes, M. (1973). The Pricing of Options and Corporate Liabilities. Journal of Political Economy.
[9] Shreve, S. (2004). Stochastic Calculus for Finance II: Continuous-Time Models. Springer.
原文链接